Usługi / Security i hardening
OchronaZabezpieczamy infrastrukturę i reagujemy, gdy coś się dzieje
Wdrażamy i utrzymujemy zabezpieczenia serwerów, chmury i aplikacji. Ograniczamy dostęp z internetu, monitorujemy zagrożenia, wykrywamy podatności i dbamy o kopie zapasowe. Nie kończymy na wdrożeniu. Monitorujemy alerty, reagujemy na incydenty i regularnie sprawdzamy, czy systemy można skutecznie odtworzyć z backupu.
Bezpieczeństwo infrastruktury od jednej strony
Łączymy ochronę ruchu, monitoring serwerów, skanowanie podatności, analizę sieci i backup w jeden proces. Dzięki temu alert nie kończy się na powiadomieniu, wiadomo, co się wydarzyło, jaki ma priorytet i kto powinien zareagować.
Ochrona infrastruktury, którą wdrażamy i utrzymujemy
Najpierw sprawdzamy obecną infrastrukturę: publiczne usługi, serwery, konta, dostęp administracyjny, sieć i backup. Na tej podstawie ograniczamy powierzchnię ataku, wdrażamy monitoring i skanowanie podatności oraz porządkujemy kopie zapasowe. Ustalamy również, które zdarzenia wymagają natychmiastowej reakcji i jak wygląda obsługa incydentu.
Co robimy
Zabezpieczamy dostęp do infrastruktury, wdrażamy monitoring bezpieczeństwa, regularnie szukamy podatności i kontrolujemy nietypowy ruch. Dbamy również o backup i możliwość odtworzenia systemów po awarii lub incydencie.
Na czym pracujemy
Korzystamy m.in. z Wazuh, OpenVAS i Cloudflare oraz narzędzi do monitorowania sieci i backupu. Dobieramy rozwiązania do istniejącej infrastruktury, nie wymagamy wymiany całego środowiska.
Dla kogo
Dla firm, dla których infrastruktura jest częścią produktu lub działania biznesu: software house'ów, ecommerce, fintechów, SaaS oraz zespołów utrzymujących własną chmurę lub serwery.
Jak chronimy infrastrukturę
Bezpieczeństwo nie opiera się na jednym narzędziu. Łączymy kilka mechanizmów, które wzajemnie się uzupełniają. Ruch z internetu filtrujemy przed dotarciem do aplikacji. Na serwerach monitorujemy zdarzenia i zmiany. Infrastrukturę regularnie skanujemy pod kątem podatności, a ruch wewnętrzny obserwujemy pod kątem nietypowych zachowań. Na końcu pozostaje backup, niezależny od środowiska produkcyjnego i regularnie sprawdzany poprzez odtworzenie.
- Jeżeli któryś z tych elementów wykryje problem, trafia on do tego samego procesu obsługi incydentów.
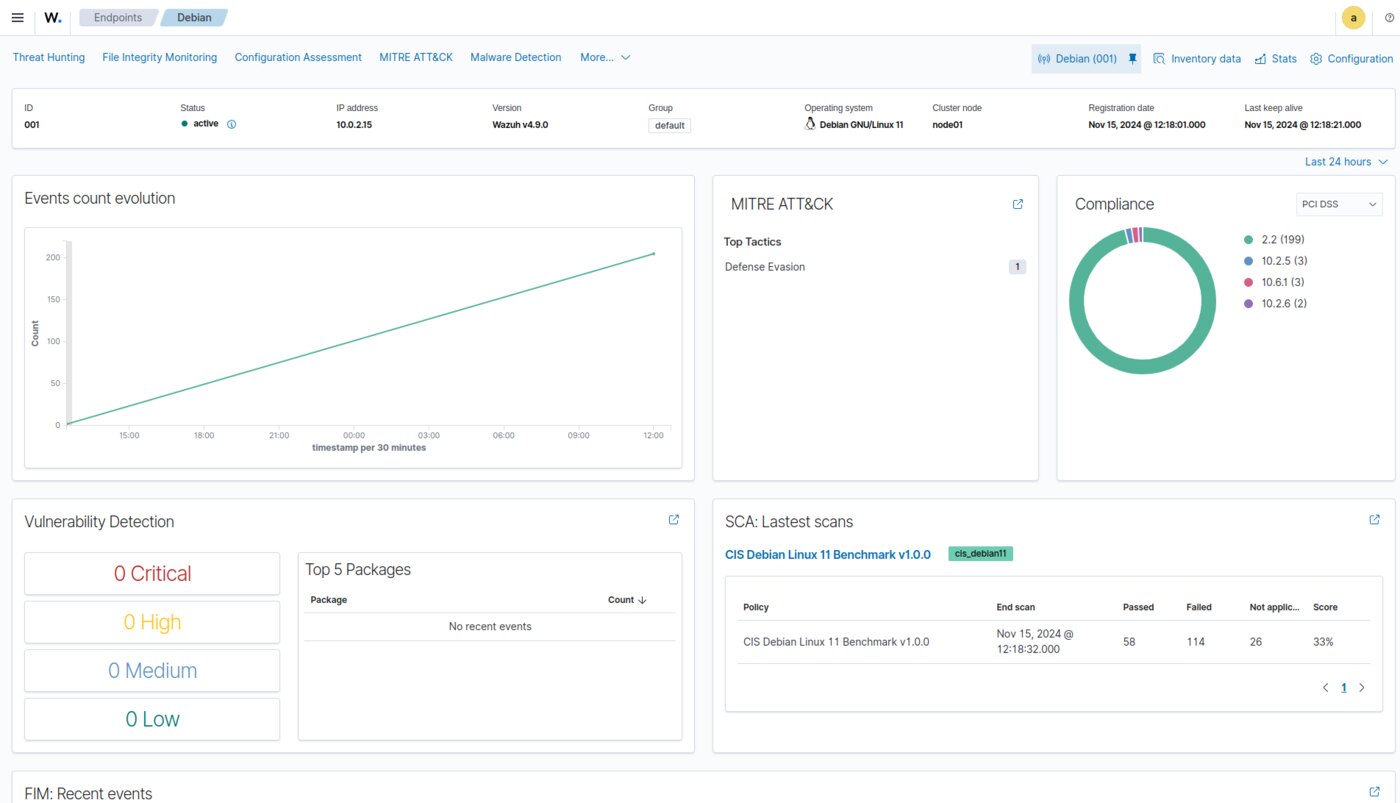
Monitorujemy serwery i reagujemy na alerty
Wdrażamy Wazuh na serwerach i integrujemy go z pozostałymi elementami infrastruktury. Dzięki temu zdarzenia bezpieczeństwa trafiają do jednego miejsca i mogą być obsługiwane według ustalonego priorytetu.
Logi
Zbieramy logi z serwerów, kontenerów, systemów, VPN, zapór i innych istotnych elementów infrastruktury.
Wykrywanie
Monitorujemy m.in. zmiany ważnych plików, próby logowania, nietypowe uprawnienia, podejrzane procesy i inne zdarzenia mogące wskazywać na incydent.
Reakcja
Alert ma określony priorytet i procedurę. W zależności od sytuacji analizujemy zdarzenie, blokujemy ruch albo izolujemy zagrożony system.
Historia zdarzeń
Zachowujemy informacje o alercie i wykonanych działaniach. Dzięki temu wiadomo, co się wydarzyło, jak zareagowano i czy potrzebne są dalsze zmiany.
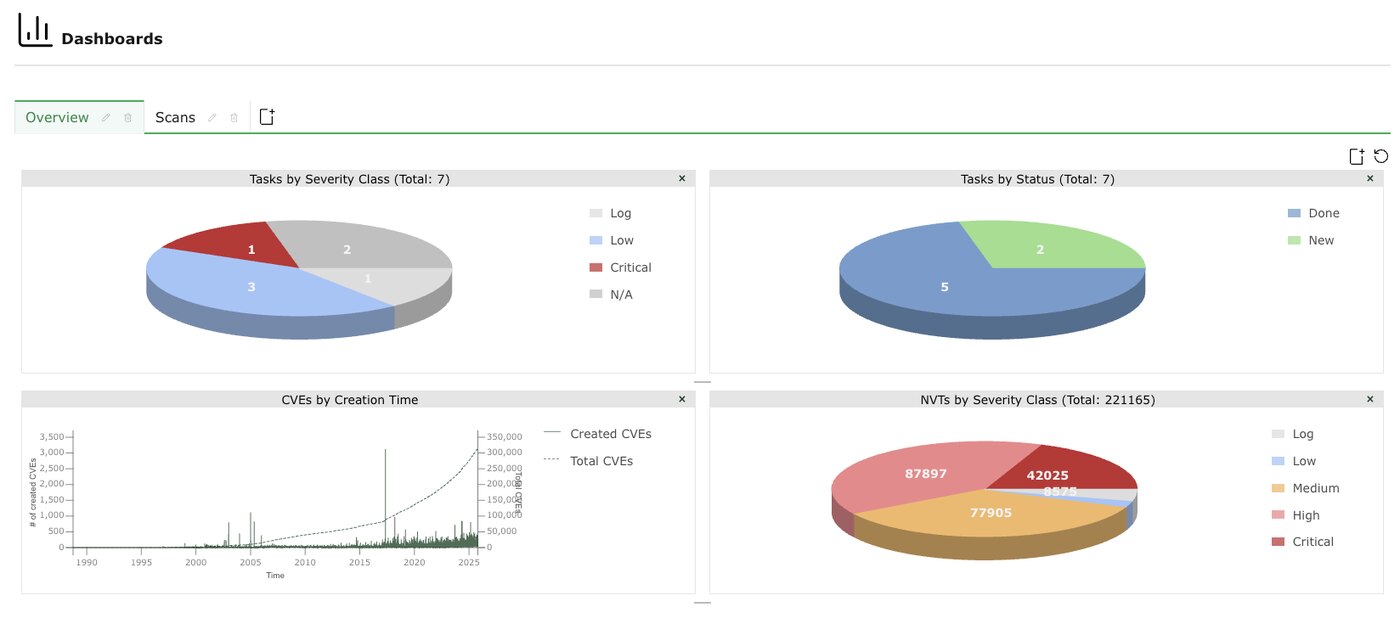
Regularnie sprawdzamy infrastrukturę pod kątem podatności
Skanujemy serwery i usługi w poszukiwaniu znanych podatności. Wyniki nie zostają tylko raportem, przekładamy je na konkretne działania i priorytety.
Zakres
Sprawdzamy produkcję, staging, serwery, panele administracyjne i inne elementy infrastruktury.
Regularne skany
Skanowanie wykonujemy cyklicznie oraz po istotnych zmianach w środowisku.
Priorytety
Najpierw zajmujemy się podatnościami, które mogą zostać wykorzystane z internetu lub dotyczą systemów przetwarzających istotne dane.
Weryfikacja
Po wdrożeniu poprawki wykonujemy ponowny skan i sprawdzamy, czy podatność została rzeczywiście usunięta.
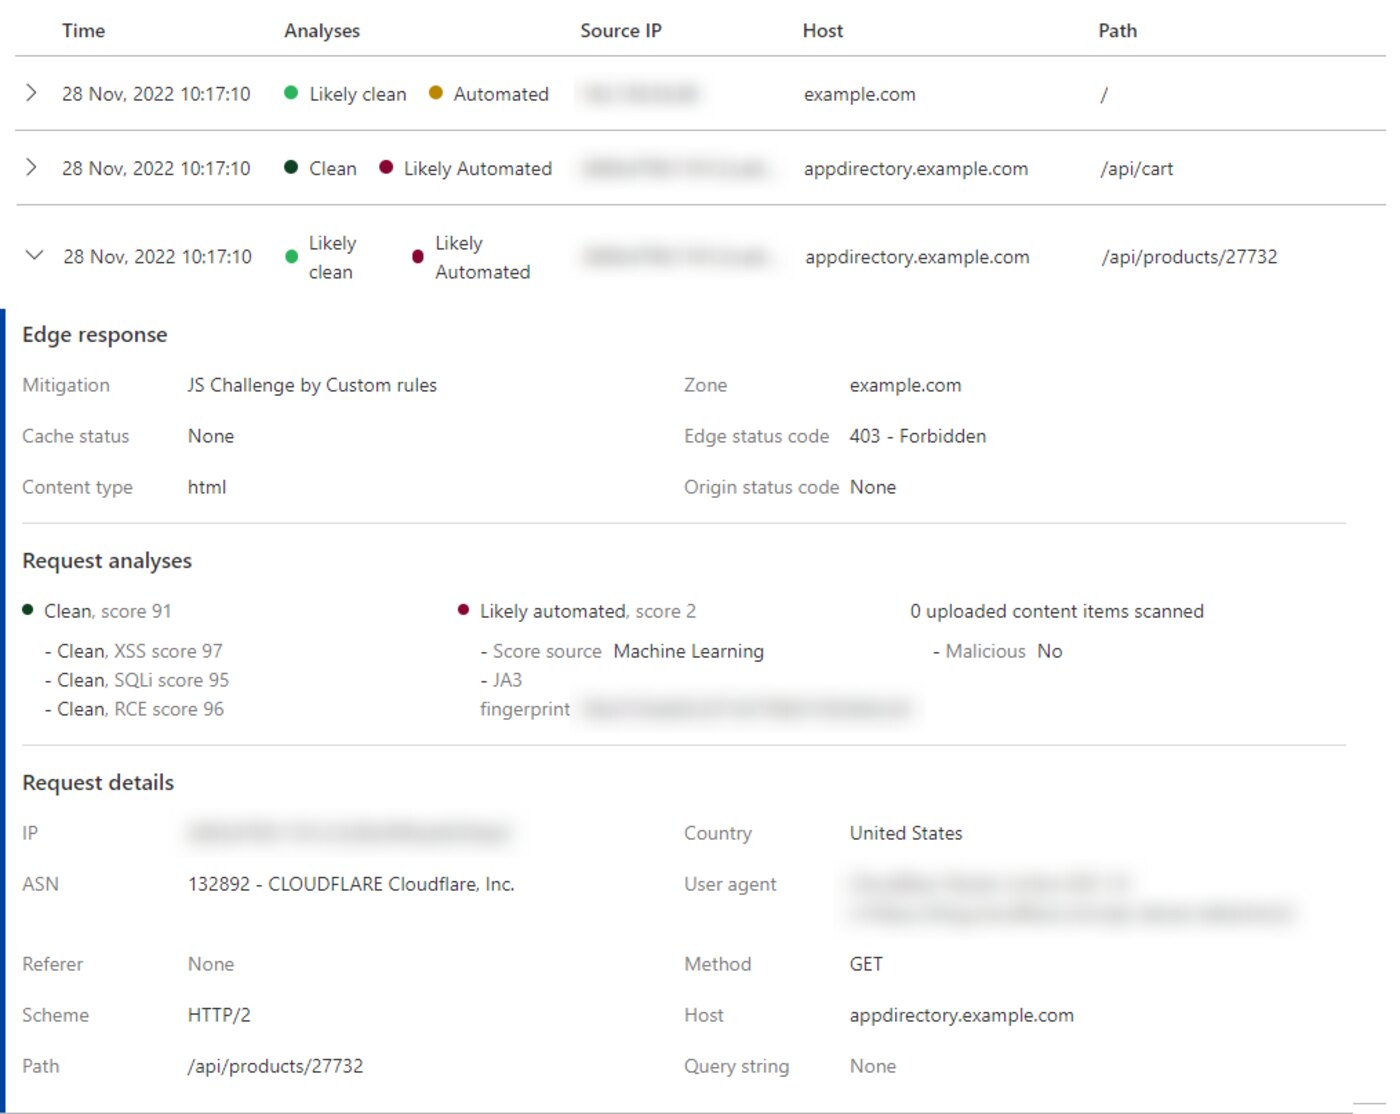
Ograniczamy zagrożenia, zanim dotrą do aplikacji
Ustawiamy ochronę pomiędzy internetem a Waszą aplikacją. Filtrujemy niepożądany ruch, ograniczamy boty i próby nadużyć oraz zmniejszamy liczbę usług dostępnych bezpośrednio z internetu.
Mniejsza powierzchnia ataku
Publicznie pozostają tylko usługi, które rzeczywiście muszą być dostępne. Dostęp administracyjny realizujemy przez VPN, kontrolę tożsamości lub inną bezpieczną ścieżkę.
WAF i reguły
Konfigurujemy reguły dopasowane do aplikacji, w tym ograniczenia prób logowania, wywołań API i podejrzanego ruchu.
Ataki DDoS i boty
Niepożądany ruch zatrzymujemy możliwie blisko krawędzi sieci, zanim obciąży właściwe serwery.
Dostęp do paneli
Grafana, staging, panele administracyjne i inne narzędzia wewnętrzne nie muszą być dostępne publicznie. Ograniczamy dostęp i wiążemy go z konkretnymi użytkownikami.
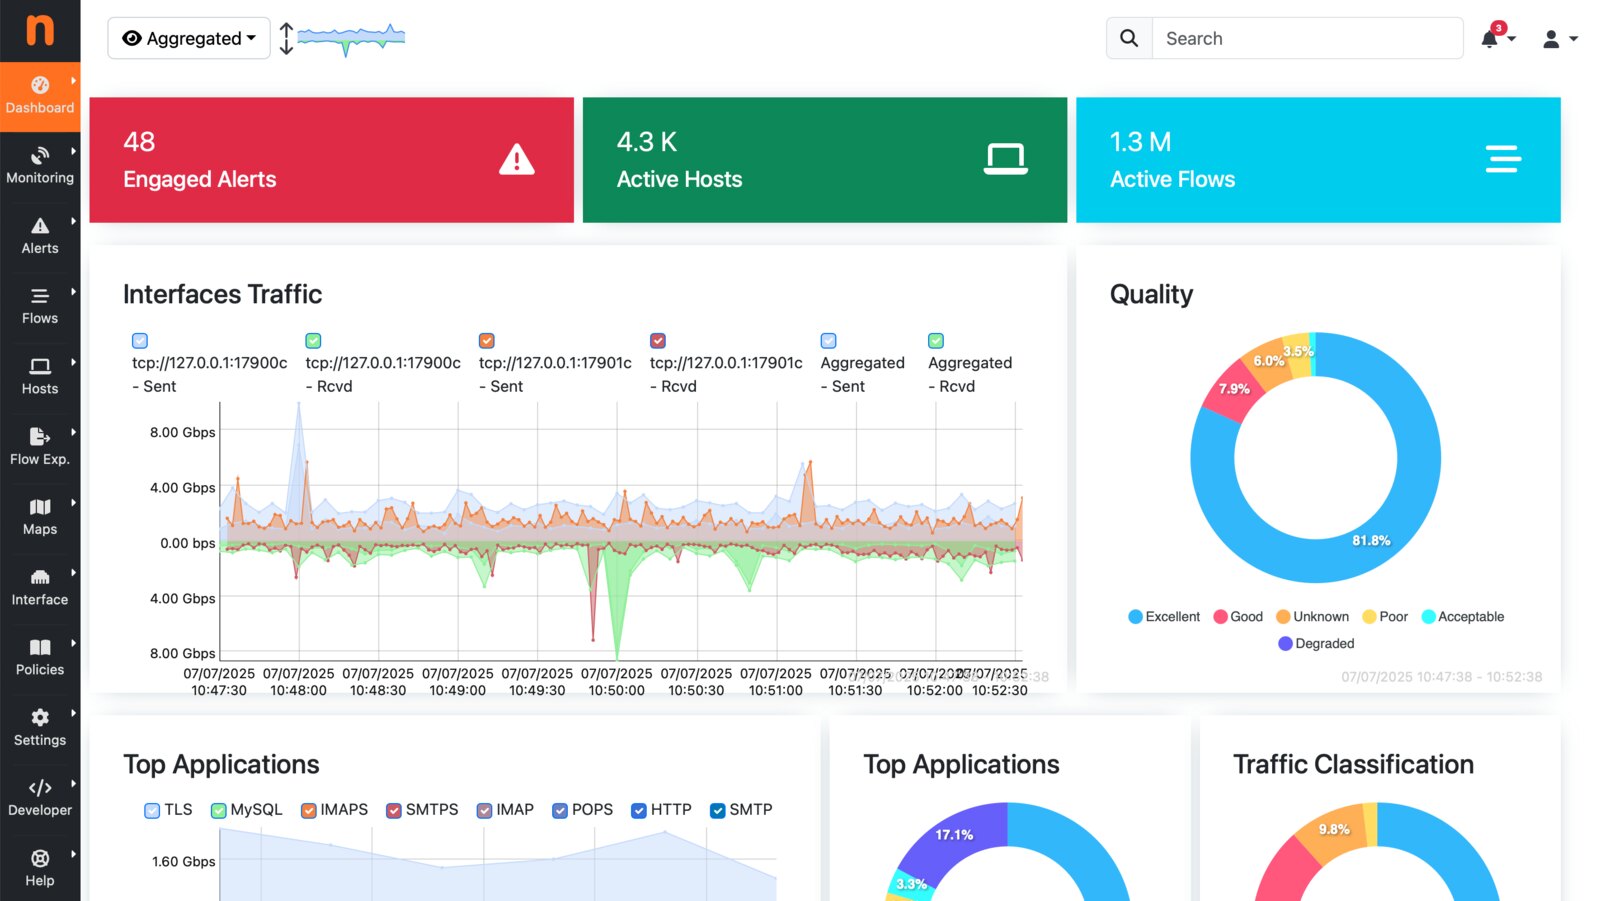
Wiemy, co komunikuje się wewnątrz infrastruktury
Nie każde zagrożenie przychodzi bezpośrednio z internetu. Dlatego obserwujemy również komunikację pomiędzy serwerami, usługami i zewnętrznymi adresami. Najpierw poznajemy normalny ruch w środowisku. Następnie wykrywamy odchylenia, które mogą wymagać sprawdzenia.
Co obserwujemy
Analizujemy połączenia pomiędzy systemami oraz ruch wychodzący do internetu.
Czego szukamy
Zwracamy uwagę m.in. na skanowanie sieci, połączenia z nieznanymi adresami, nietypowe porty i nagły wzrost transferu wychodzącego.
Alert
Przy podejrzanym zdarzeniu sprawdzamy, który system rozpoczął komunikację, dokąd prowadzi połączenie i czy pasuje ono do normalnego działania aplikacji.
Strojenie
Reguły dostosowujemy do rzeczywistego ruchu w środowisku, żeby ograniczyć liczbę niepotrzebnych alertów.
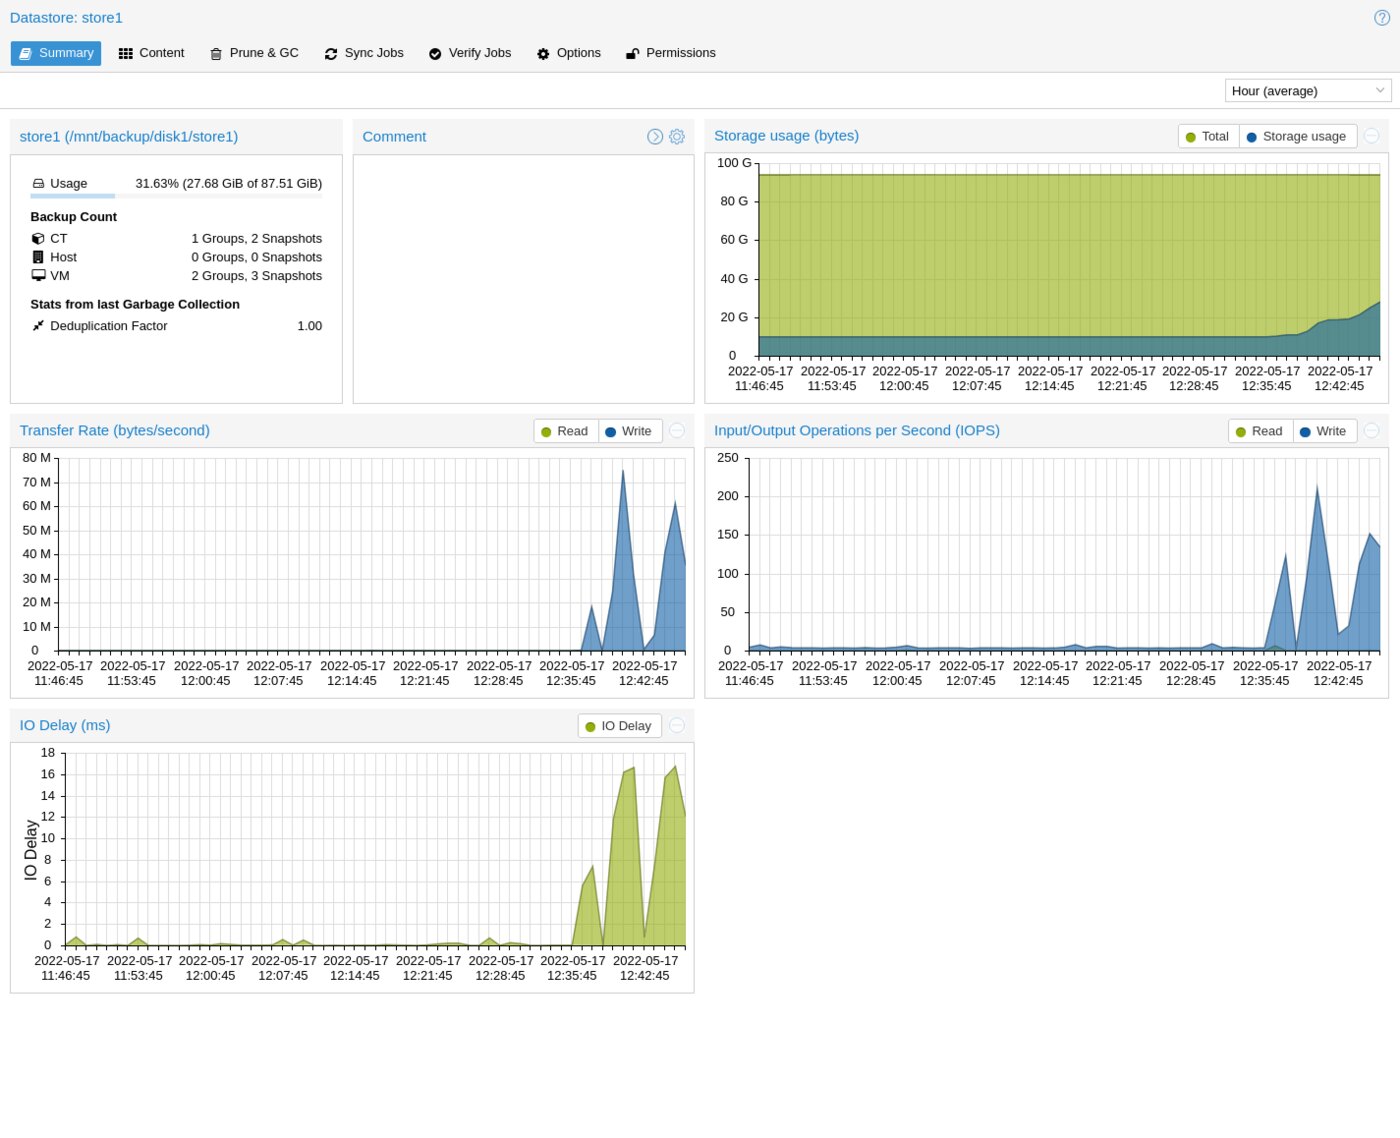
Backup, który można rzeczywiście odtworzyć
Samo wykonanie kopii nie oznacza jeszcze, że dane są bezpieczne. Dlatego projektujemy backup tak, aby awaria, błąd administratora lub przejęcie produkcji nie pozwoliły usunąć wszystkich kopii jednocześnie.
Lokalna
Kopia lokalna
Pierwszą kopię utrzymujemy blisko środowiska produkcyjnego. Pozwala szybko odtworzyć dane po typowej awarii lub błędzie.
Zewnętrzna
Kopia poza środowiskiem
Drugą kopię przechowujemy niezależnie, na innym koncie, w innym środowisku lub u innego dostawcy. Oddzielamy dostęp, klucze i uprawnienia tak, aby przejęcie produkcji nie oznaczało automatycznie dostępu do backupu.
Co kopiujemy
W zależności od środowiska zabezpieczamy bazy danych, dyski, konfigurację oraz pliki aplikacji.
Testy odtworzenia
Regularnie wykonujemy restore i sprawdzamy, czy dane oraz systemy można rzeczywiście odzyskać.
Monitoring
Nieudany backup, problem z retencją lub zmiana zabezpieczeń kopii generuje alert tak samo jak inne problemy infrastrukturalne.
Jak wygląda współpraca
Od audytu do stałego utrzymania
Nie wdrażamy zestawu narzędzi w ciemno. Najpierw poznajemy środowisko i ustalamy, które elementy rzeczywiście wymagają zabezpieczenia.
- Analiza Sprawdzamy serwery, publiczne usługi, dostęp administracyjny, sieć, konta i obecny sposób wykonywania kopii zapasowych.
- Wdrożenie Ograniczamy powierzchnię dostępną z internetu, wdrażamy monitoring, skanowanie podatności i uporządkowany backup.
- Strojenie Dostosowujemy alerty i reguły do rzeczywistego działania infrastruktury. Ustalamy priorytety oraz procedury reakcji.
- Utrzymanie Monitorujemy alerty, analizujemy podatności, reagujemy na incydenty i regularnie testujemy odtworzenie danych.
Technologie i podział pracy
Czym Wazuh różni się od zwykłego zbierania logów?
Samo zbieranie logów pozwala sprawdzić, co wydarzyło się w systemie. Wazuh dodatkowo analizuje zdarzenia, wykrywa określone zachowania i generuje alerty, które mogą trafić bezpośrednio do procesu obsługi incydentu.
Czy OpenVAS zastępuje test penetracyjny?
Nie. OpenVAS pozwala regularnie wykrywać znane podatności i błędy konfiguracji. Test penetracyjny obejmuje szerszą analizę i próby wykorzystania konkretnych słabości aplikacji lub infrastruktury.
Czy musimy już korzystać z Cloudflare, Wazuh i OpenVAS?
Nie. Możemy wdrożyć brakujące elementy albo zintegrować rozwiązania, których już używacie. Konkretne narzędzia dobieramy do środowiska.
Co zostaje po stronie naszego zespołu?
Zakres ustalamy przed rozpoczęciem współpracy. Możemy przejąć utrzymanie całego procesu albo pracować razem z Waszym zespołem IT i reagować tylko na ustalone klasy zdarzeń.
Rozmowa
Porozmawiajmy o bezpieczeństwie Waszej infrastruktury
Sprawdzimy, co jest dostępne z internetu, jak obecnie wykrywacie problemy i czy po poważnej awarii lub incydencie da się skutecznie odtworzyć systemy. Na tej podstawie przygotujemy konkretny zakres wdrożenia i dalszego utrzymania.
Skontaktuj się